September 17, 2026
Все хотят прогнозировать продажи. Но мало кто задумывается над тем, что на самом деле видит модель, когда смотрит в данные. Машинное обучение стало must-have для ритейла: модели спроса и персонализированные акции – всё звучит красиво.
Но несмотря на высокие ожидания, большинство моделей либо не приносят ощутимого эффекта, либо работают только в ограниченной среде. Это подтверждает и систематический обзор Why Big Data Projects Fail, согласно которому более 80% инициатив, связанных с большими данными и ML, проваливаются. И дело не в слабых алгоритмах или некомпетентных командах. Просто очень часто модели строятся на данных, которые не учитывают реального контекста.
В этой статье мы разберём, почему даже самые продвинутые time series-модели могут ошибаться в базовых вещах. И что нужно учитывать, чтобы прогнозы действительно помогали принимать решения вместо того, чтобы их имитировать.
Представим классическую ситуацию: аналитик получает таблицу с историческими продажами. Данные ежедневные, по каждому SKU, с количеством единиц. Формально – это идеальный time series для прогнозирования: всё выглядит чисто, логично и структурировано.
На этом этапе чаще всего и начинается разработка модели. И не так важно, какая для этого используется time series-архитектура, потому что важно совсем другое: что именно видит модель.
А видит она, как правило, только одну грань событий – результат. Продажи.
С точки зрения алгоритма всё это просто цифры: был пик, было падение. Большинство ML-моделей в ритейле построены вокруг продаж, и это логично: именно продажи являются финальным результатом взаимодействия товара с покупателем. Но здесь и заложена основная ошибка: продажа — это следствие, а не причина. За колебаниями продаж могли стоять обстоятельства, которые никак не связаны с реальным спросом на продукт.
Модель начинает прогнозировать поведение, которое в реальном мире никогда не повторится. Потому что она базируется на исключениях, а не на закономерностях.
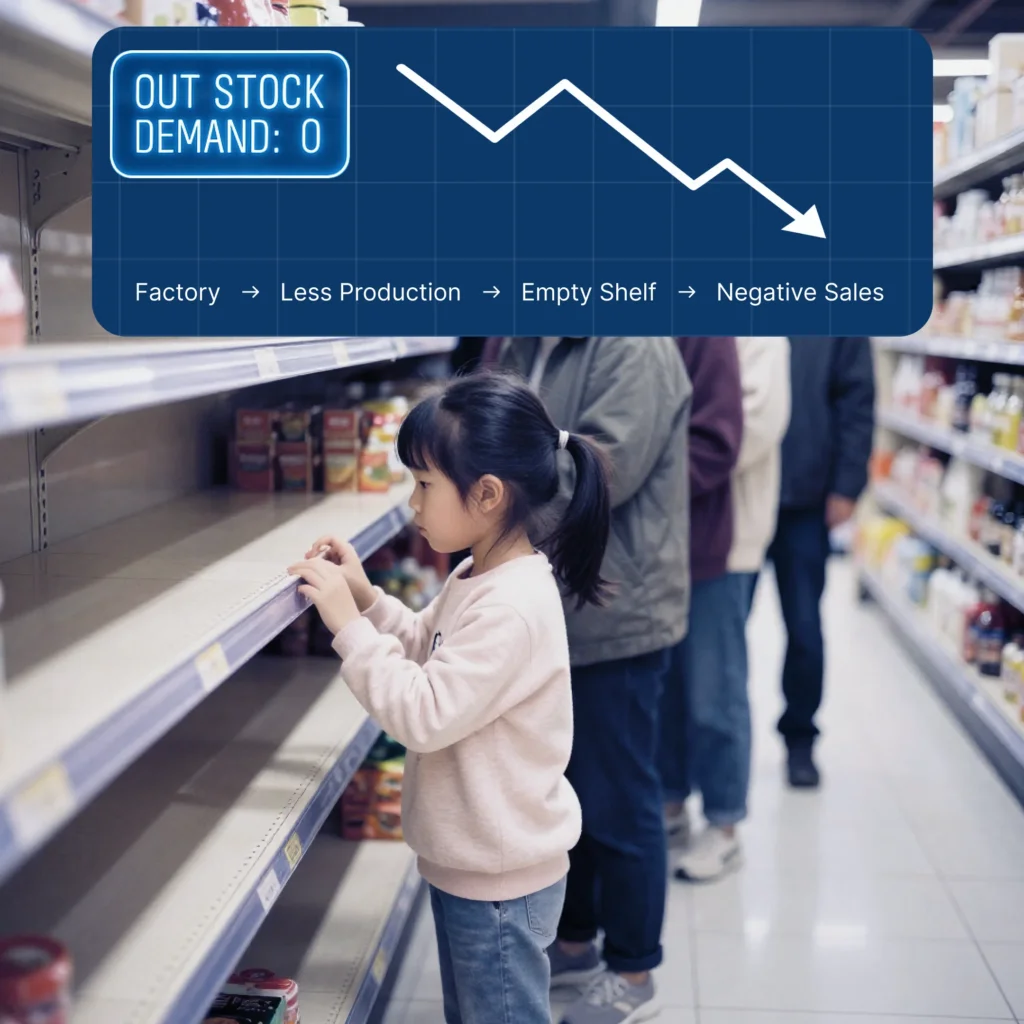
Если товара не было на полке, логично, что и продаж не будет. Но это совсем не означает, что на него не было спроса, это просто значит, что покупатель не имел возможности сделать покупку. И если модель «учится» на этом периоде, она ошибочно интерпретирует отсутствие продажи как отсутствие заинтересованности.
Поэтому в модели обязательно должен быть полноценный массив по остаткам. Иначе прогноз будет ошибочным.
Акции, распродажи, купоны, 2+1, push-уведомления, баннеры, новая упаковка – всё это кардинально влияет на потребительское поведение. Но эти данные часто отсутствуют или хранятся отдельно от основного датасета.
Без информации о промо-активностях модель будет анализировать аномалии (резкий рост или падение) как обычные тренды. И прогнозировать их повторение там, где этого не будет.
Если вы анализируете конкретный товар – этого недостаточно. Покупатель не выбирает в изоляции. Он видит несколько альтернатив на полке (или на странице каталога), и реагирует на весь контекст.
Например, если конкурент исчез с полки, это могло дать товару краткосрочный прирост. Но модель, которая не знает этого, решит, что причина в популярности продукта.
Тот же товар может продаваться по-разному в зависимости от города, типа магазина, дистрибуционной модели, глубины полки, доставки. Всё это важно.
5. Физические изменения товара (SKU-атрибутика)
Многие модели не учитывают, что SKU – это лишь технический код. А товар, который стоит на полке, может меняться, не меняя кода.
Даже без глубокого аудита можно заметить, что модель ведёт себя подозрительно. Она не обязательно не работает в прямом смысле, но её прогнозы не совпадают с реальностью или противоречат здравому смыслу.
Вот несколько признаков, которые стоит воспринимать как сигналы тревоги:
Поговорим подробнее об одном из самых типичных искажений в прогнозных моделях: когда модель интерпретирует отсутствие продаж как отсутствие спроса. Это логично с точки зрения цифр, но абсолютно ошибочно с точки зрения реального бизнеса. Ноль продаж – это ещё не приговор продукту. Это часто является сигналом, что товар физически не был доступен покупателю. Проблема в том, что ML-модели без учёта остатков не могут это увидеть. А для принятия правильных решений, бизнесу необходимо видеть одновременно два вектора: Что покупают (спрос) и что физически есть в наличии (остатки).
Во время разработки модели для прогнозирования производства для компании Новые Продукты наша команда напрямую столкнулась с ситуацией, когда модель видела просадку спроса, хотя товара просто не было на полках в некоторых точках. В таких случаях аналитика лишь создаёт иллюзию контроля вместо того, чтобы давать реальную опору для решений. Этот момент стал критическим в настройке модели: мы интегрировали данные об остатках, чтобы чётко отличать реальные колебания спроса от ситуаций, когда просто не было что продавать. Мы подключили полные данные об остатках по SKU, разграничили ситуации, где был спрос, но не было товара и смогли повысить точность прогноза. Это помогло избежать перепроизводства, уменьшить потери и принимать обоснованные решения на основе реальных данных.
Слабые модели дают слабые прогнозы. Но ещё хуже, когда сильная модель работает на неполных данных и создаёт уверенность там, где её не может быть.
Машинное обучение в ритейле работает только тогда, когда модель видит полную картину. Никакая архитектура не компенсирует отсутствие понимания, что именно стоит за цифрами. Ведь качественный прогноз базируется не только на самих данных, но и на контексте, из которого эти данные выросли.
Именно так мы подходим к работе в IWIS: наши модели эффективны не в теории, а в реальных условиях. Если хотите узнать, как это может работать у вас – мы на расстоянии одного сообщения.
За последние годы искусственный интеллект настолько...
Читать далее Не чат-ботом единым: AI-решения для общения с клиентом