
September 17, 2026
Когда Netflix решал, вкладывать или не вкладывать 100 млн $ в «Карточный домик», у них не было пилотного эпизода, не было фокус-групп и не было гарантий. Но были данные: подписчики, которые смотрели британский оригинал, почти всегда смотрели фильмы Дэвида Финчера. И почти всегда смотрели их до конца. А те, кто любил Финчера, стабильно выбирали Кевина Спейси. Три точки пересечения на диаграмме Венна – и решение принято. Алгоритм не гарантировал хит, но убрал из уравнения слепую ставку. Это и есть прогнозная аналитика бизнеса в действии: структурированная работа с данными о будущем.
Часто компании, которые уже внедрили аналитику, работают с прошлым: какой была продажа в октябре, сколько клиентов отвалилось в квартале, где упала маржа. Это полезно, но это ретроспектива. Прогнозная аналитика сдвигает фокус вперёд: что произойдёт в следующем месяце, кто из клиентов уходит, какая категория товаров может просесть. То есть Predictive analytics в Украине для многих компаний начинается с простого вопроса: что будет со спросом, клиентами или выручкой в ближайшие месяцы.
Удобно понимать аналитику как три уровня зрелости, где каждый следующий даёт больше рычагов для решений:
| Уровень | Что спрашивает | Что даёт |
|---|---|---|
| Descriptive (описательная) | Что произошло? | Отчёты, дашборды, KPI за прошедший период |
| Predictive (прогнозная) | Что произойдёт? | Модели прогноза: спрос, отток, выручка |
| Prescriptive (предписывающая) | Что делать? | Рекомендации: снизить цену, запустить retention-кампанию, пополнить склад |
Большинство украинского бизнеса сегодня находится на первом уровне, и это уже хорошо. Дашборды и отчёты дают обзор того, что происходит прямо сейчас, но как только бизнес хочет не просто фиксировать ситуацию, а управлять ею на опережение – нужен переход к predictive. BI объясняет прошлое, predictive analytics работает с будущим: что произойдёт и что с этим делать уже сейчас.
Если хотя бы два пункта резонируют, компания уже переросла описательную аналитику.
Прогнозные модели можно строить под что угодно: от почасовой загрузки кол-центра до вероятности брака на производстве. Но если цель – быстро увидеть окупаемость, есть четыре направления, где методы прогнозирования дают наиболее ощутимый и измеримый результат.
Для любого бизнеса с товарными остатками избыток и дефицит – это замороженные или потерянные деньги. На практике прогноз спроса (аналитика продаж, сезонности, остатков и внешних факторов) помогает ответить на очень прикладной вопрос: сколько товара произвести, закупить или переместить между складами. Прогноз спроса на основе ML-моделей учитывает также внешние факторы: погоду, праздники, рекламную активность, даже поведение конкурентов. В результате склад пополняется заранее там, где будет спрос, и не затоваривается там, где его не будет.
Churn prediction – одна из самых популярных задач машинного обучения в бизнесе, и не случайно: удержать клиента дешевле, чем привлечь нового, а модель даёт время действовать до того, как решение принято.
Модель оттока анализирует поведенческие сигналы: снижение частоты покупок, падение среднего чека, отсутствие реакции на коммуникации, изменение паттерна использования продукта. На выходе – список клиентов с наивысшей вероятностью ухода и рекомендуемый тип вмешательства для каждого сегмента.
Для подписных сервисов, банков, телекома и любого бизнеса с регулярными транзакциями churn prediction окупается уже в первые месяцы после внедрения.
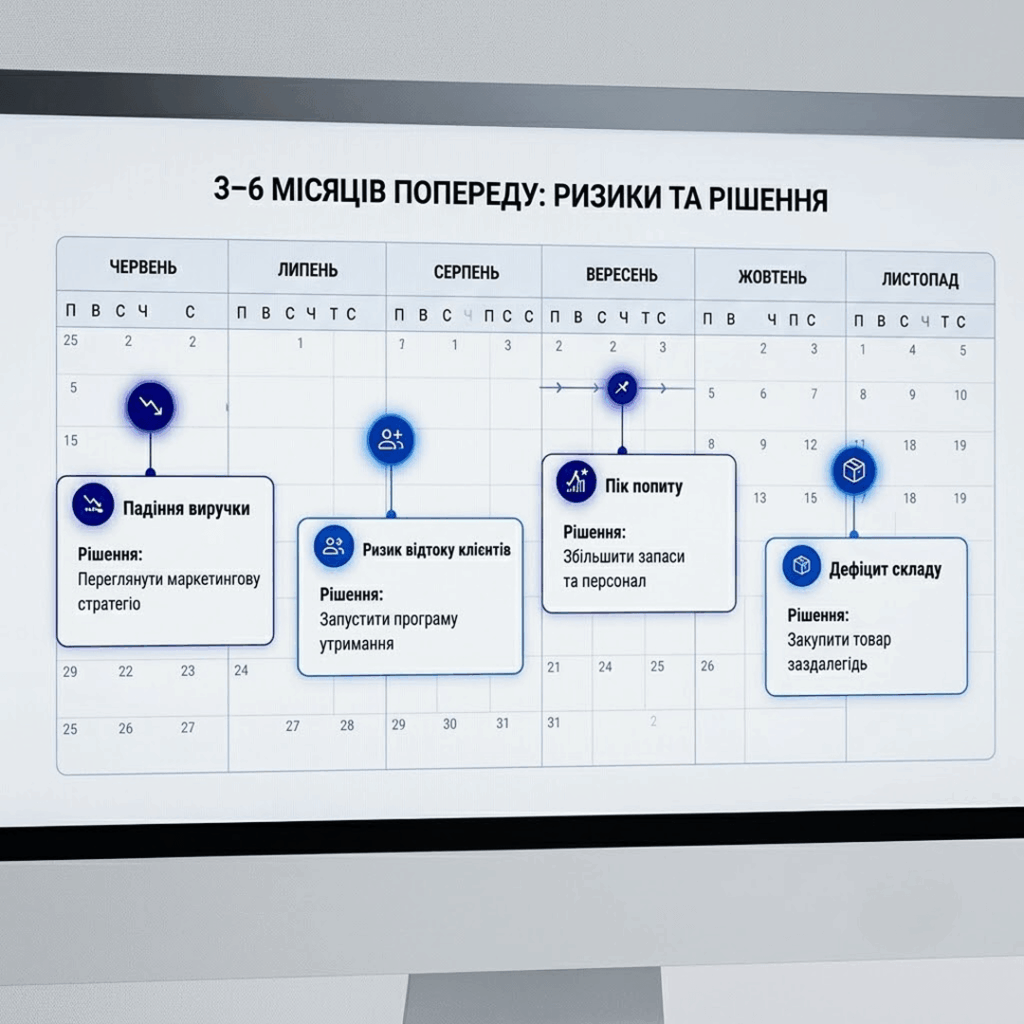
Прогнозирование выручки на 3-6 месяцев вперёд даёт понимание диапазона: оптимистичный сценарий, реалистичный, стрессовый. Такой подход позволяет финансовому директору заранее видеть кассовые разрывы, управлять платёжным календарём и не заниматься пожарным фандрейзингом в момент, когда кризис уже наступил.
ML-модель учитывает сезонность, pipeline сделок из CRM, рыночные тренды и даже поведение конкретных менеджеров по продажам: кто обычно выполняет план, а кто системно переоценивает воронку.
Скоринг – это прогноз продаж или кредитного риска на уровне отдельного лида или заёмщика. Банки и финтех-компании используют его для оценки кредитоспособности, но та же логика работает и в B2B-продажах: модель оценивает каждый лид и даёт менеджеру приоритет: с кем стоит говорить первым, потому что вероятность закрытия сделки самая высокая. В продажах те же подходы работают как методы прогнозирования продаж: модель оценивает вероятность закрытия сделки, ожидаемую сумму, риск переноса дедлайна и приоритетность лида для менеджера.
Аналитики данных шутят, что 80% их работы – это очистка данных, и 20% – жалобы на очистку данных. За этой шуткой стоит реальная структура процесса: четыре этапа, где самый долгий и самый скучный – подготовительный.
Самая распространённая проблема на этом этапе – данные есть, но они разрознены между разными системами, хранятся в разных форматах или имеют пропуски. Именно поэтому построение прогнозной модели почти всегда начинается с data engineering.
Алгоритм выбирается под задачу. Коротко об основных:
| Алгоритм | Когда подходит | Типовая задача |
|---|---|---|
| Linear/Logistic Regression | Простая зависимость, мало переменных, нужна интерпретируемость | Базовый прогноз выручки, скоринг |
| Random Forest/Gradient Boosting | Много факторов влияния, нелинейные зависимости | Прогноз спроса, churn, лид-скоринг |
| LSTM (нейронные сети) | Сложные временные ряды с долгой памятью | Прогноз спроса, churn, лид-скоринг |
На практике Gradient Boosting (в частности XGBoost и LightGBM) закрывает большинство бизнес-задач лучше всего остального: он устойчив к шуму в данных, хорошо работает на средних объёмах и даёт понятные объяснения, какие признаки больше всего повлияли на прогноз.
Модель обучается на части данных – условно, на 80% – и проверяется на остальных 20%, которые она не видела. Это позволяет понять, насколько хорошо модель обобщает закономерности.
Но для бизнес-моделей есть нюанс: обычное случайное разбиение здесь не подходит. Если обучать модель прогнозирования продаж на данных за 2020-2024 годы, а тестировать на случайной выборке из того же промежутка – модель может выглядеть точной, но в реальности она «подсмотрела» в будущее во время обучения. Поэтому для временных рядов всегда используется хронологическое разбиение: обучение на раннем периоде, тестирование на более позднем.
После валидации модель выходит в продакшн, и начинается постоянный мониторинг: если поведение рынка изменилось, точность модели падает и её нужно переобучать.
Выбор инструмента зависит от трёх вещей: где живут ваши данные, какой уровень технической команды и какой масштаб задачи. Нет лучшего стека, но есть подходящий под конкретную ситуацию.
Базовый стек для большинства проектов с машинным обучением для бизнеса. Scikit-learn является библиотекой с открытым кодом, которая содержит реализации практически всех классических алгоритмов: от линейной регрессии до random forest и gradient boosting. Она бесплатная, хорошо задокументирована и является стандартом в среде data science.
Поверх scikit-learn обычно добавляют XGBoost или LightGBM для задач на табличных данных и Prophet или statsmodels для временных рядов. Этот стек покрывает 80% реальных бизнес-задач и не привязывает ни к одному облачному провайдеру.
Облачные платформы имеют смысл, когда задача выходит за пределы одного ноутбука: нужно обучать большие модели, автоматизировать переобучение, версионировать модели или разворачивать их как API для продакшн-систем.
Azure ML – логичный выбор для компаний, которые уже используют Microsoft-инфраструктуру: Power BI, Azure Synapse, Microsoft Fabric. Платформа ориентирована на простоту и быстрый старт, имеет drag-and-drop интерфейс для менее опытных команд, но в то же время поддерживает полный код для data scientists.
Google Vertex AI – более сильный вариант, если данные уже в Google Cloud или BigQuery. Кривая обучения здесь круче, но платформа лучше подходит для сложных ML-пайплайнов и больших объёмов данных.
Отдельный сценарий – когда прогнозная модель уже построена, но результаты нужно сделать доступными для бизнес-пользователей без технического бэкграунда. Power BI позволяет встраивать Python и R скрипты непосредственно в отчёты: модель запускается на бэкенде, а менеджер видит готовый прогноз в дашборде рядом с фактическими показателями.
Это решение не для обучения моделей, но идеальное для их демократизации внутри компании, когда кастомная разработка ML-моделей для бизнеса уже сделана и нужно интегрировать результаты в ежедневную работу команды.
Вот три проекта, реализованных командой IWIS, где прогнозная аналитика решала конкретные бизнес-задачи.
Новые Продукты: прогноз производства слабоалкогольных напитков
Группа компаний «Новые Продукты» столкнулась с классической дилеммой производителя: избыточные остатки стоят денег, дефицит – доли рынка. Задача состояла в том, чтобы прогнозировать спрос достаточно точно для оптимизации производственного плана.
Команда IWIS построила ML-модель на основе данных розничного потребления. Главным техническим вызовом стало низкое качество входных данных: в торговых точках не фиксировались нулевые остатки, поэтому отсутствие продаж невозможно было однозначно трактовать: товар закончился или просто не продавался? Для решения применили методы аппроксимации, которые позволили корректно интерпретировать аномалии. После серии итераций с разными ML-библиотеками и архитектурами модель достигла точности прогнозирования на уровне 80%.
Планета Кино: модель оттока клиентов
Сеть кинотеатров «Планета Кино» поставила задачу снизить churn среди активных клиентов. Команда IWIS проанализировала транзакционную историю более чем за год, выделила кластеры клиентов со схожим поведением и проверила результаты кластеризации через глубинные интервью с реальными посетителями – чтобы убедиться, что математические кластеры соответствуют реальным поведенческим паттернам.
На основе кластеров построили модель прогнозирования оттока, которая учитывала принадлежность к кластеру как явный параметр. После интеграции модели с CRM Salesforce Marketing Cloud и запуска коммуникационных цепочек под разные уровни вероятности оттока – показатель churn снизился с 13% до 7%, а средний LTV клиента вырос.
Edenred: управление портфелем B2B-клиентов
Edenred нуждался в инструменте для раннего выявления риска оттока в B2B-сегменте, где потеря одного контракта стоит намного больше, чем в рознице. Отдельным вызовом стала необходимость анонимизации клиентских данных в соответствии с требованиями GDPR, поскольку обработка осуществлялась за пределами юрисдикции ЕС. Команда предложила безопасный технический подход, который отвечал всем регуляторным требованиям. Результатом стала стабильно работающая churn prediction-модель, интегрированная во внутренние процессы управления рисками компании.
Это вопрос, на который редко дают быстрый ответ, потому что он зависит от слишком многих переменных. Но можно очертить логику формирования стоимости.
Цена складывается из трёх компонентов: подготовка данных, разработка модели, интеграция и поддержка. На практике подготовка данных часто становится самым большим блоком работы: data engineering, очистка, согласование источников и построение pipeline могут занять больше времени, чем сама разработка первой версии модели. Именно поэтому компании, у которых уже есть упорядоченная BI-система как основа для прогнозной аналитики, стартуют быстрее и дешевле.
Начинать с самого амбициозного сценария является типичной ошибкой. Намного разумнее запустить пилот на одной задаче, получить первый измеримый результат и уже на его основе принимать решение о масштабировании. Так выглядит большинство успешных внедрений, включая кейс «Новые Продукты», где первая версия модели была намеренно упрощённой, но позволила выиграть тендер и доказать гипотезу.
Если на большинство вопросов ответ положительный, данные готовы и можно двигаться к разработке.
Если вы хотите понять, какая задача имеет наибольший потенциал ROI в вашем бизнесе, и готовы ли ваши данные к ML-моделированию – запишитесь на бесплатную консультацию. Мы разберём вашу ситуацию и дадим конкретный вывод.
DAX отвечает за расчёты внутри модели...
Читать далее DAX формулы в Power BI: практический гайд


